La version courte
Les agents IA sont passés de boucles fragiles autour d’un modèle de langage à des systèmes capables d’inspecter des fichiers, d’utiliser des outils, d’exécuter des tests et de soumettre leur travail à une révision humaine. Les modèles ont progressé, mais le système qui les entoure compte autant.
- ReAct proposait dès 2022 une boucle utile de raisonnement, d’action et d’observation, mais les premiers agents manquaient d’outils fiables, de modèles puissants et de moyens de vérifier leur travail.
- Un agent de programmation utile combine le modèle avec des interfaces d’outils, des sandboxes, des tests, des diffs, des points de contrôle et une approbation humaine.
- Commencez par les tâches dont les erreurs sont visibles et réversibles, puis mesurez les résultats sur du vrai travail plutôt que de vous fier seulement aux benchmarks.
Vous pouvez aujourd’hui décrire une tâche de programmation en langage courant, laisser travailler un agent et revenir devant des fichiers modifiés, une application qui tourne ou une pull request. Parfois, le résultat est vraiment bon. Il y a trois ans, le même agent aurait pu passer ce temps à inventer des sous-tâches et à brûler des tokens.
Alors, qu’est-ce qui a changé ? Je voulais rassembler toute la chronologie, parce que la réponse est plus utile que « les modèles sont meilleurs ». L’histoire part de ReAct et ChatGPT, puis traverse BabyAGI, AutoGPT, Devin, Claude Code, Codex, Cowork et OpenClaw. Elle comprend aussi les résultats qui devraient nous empêcher de crier victoire trop vite.
Je suis Louis-François, CTO et cofondateur de Towards AI. Voici comment je comprends ce changement et où je crois que les agents sont utiles aujourd’hui.
La boucle existait avant ChatGPT
L’article ReAct a été soumis en octobre 2022, un mois avant le lancement de ChatGPT. Son idée centrale consistait à entrelacer raisonnement, actions et observations. Un agent pouvait choisir la prochaine étape, utiliser une source externe ou un outil, voir ce qui s’était passé et adapter son plan. On reconnaît encore ce schéma dans les produits actuels.
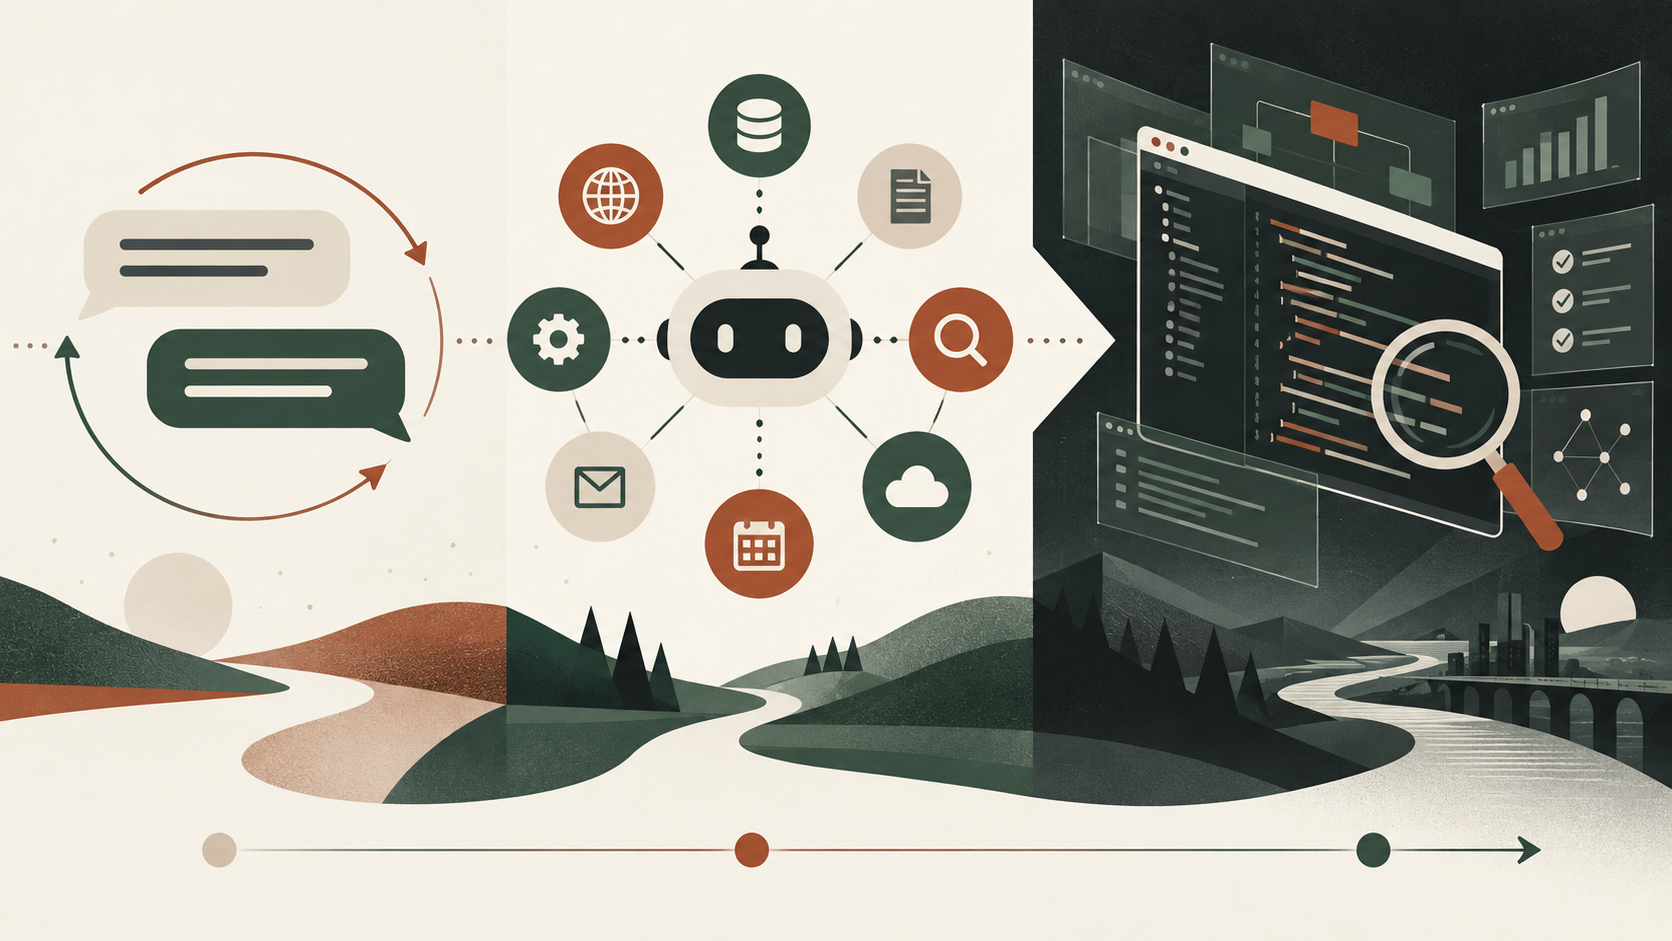
Mais le mot « agent » désignait autre chose en 2023. Souvent, c’était une boucle de chat avec un objectif ajouté par-dessus. Un agent de programmation moderne peut travailler dans un environnement isolé, lire et modifier un dépôt, appeler des outils, lancer des tests, montrer un diff, enregistrer des points de contrôle et remettre le changement à un humain pour approbation. La boucle est restée. Le système autour a mûri.

2023 : l’enthousiasme devançait les outils
GPT-4 a donné aux développeurs un modèle bien plus puissant en mars 2023. Les plugins de ChatGPT ont ensuite rendu concret le passage de « que peut dire le modèle ? » à « que peut faire un système relié au modèle ? ».
Quelques jours plus tard sont arrivés BabyAGI et Auto-GPT. La promesse était attirante : donner un objectif à une boucle, la laisser décomposer le travail et espérer qu’elle continue jusqu’au bout. En pratique, ces premiers agents pouvaient perdre de vue l’objectif, halluciner une sous-tâche, répéter une action ou accumuler les appels API coûteux. La démo ressemblait à de l’autonomie. Le travail terminé, beaucoup moins.
Les progrès moins spectaculaires concernaient la plomberie. L’API d’appel de fonctions d’OpenAI facilitait la définition d’outils et la réception d’arguments structurés. Elle ne réglait ni le raisonnement ni la fiabilité, mais supprimait une source de parsing fragile. Plus tard, les Structured Outputs ont renforcé le respect des schémas JSON pris en charge. Ce sont des améliorations graduelles d’ingénierie, mais elles comptent lorsqu’un agent doit exécuter des centaines d’actions.
Le domaine a aussi commencé à mesurer les tâches de bout en bout. Dans WebArena, le meilleur agent fondé sur GPT-4 dans l’article initial terminait 14,41 % des tâches, contre 78,24 % pour les humains. SWE-bench utilisait de vrais problèmes GitHub et des tests pour évaluer si les modèles produisaient des correctifs fonctionnels. Ses premiers résultats étaient tout aussi modestes. Ces benchmarks ne rendaient pas les agents fiables. Ils montraient mieux le chemin qui restait à parcourir.
AutoGen de Microsoft explorait plusieurs agents aux rôles spécialisés qui discutent entre eux. Un planificateur, un programmeur, un critique et un testeur peuvent former une bonne architecture. Mais multiplier les agents ne corrigeait pas automatiquement les faiblesses du modèle ou des outils. La coordination ajoute aussi ses propres risques d’échec.
2024 : un véritable environnement prend forme
LangGraph a facilité la création de cycles, la gestion de l’état et les points d’approbation humaine. Devin a rendu l’idée d’un agent de programmation plus concrète pour un grand public, avec sa sandbox, son éditeur, son shell et son navigateur. Le lancement a retenu l’attention parce que l’agent travaillait enfin dans quelque chose qui ressemblait à l’environnement d’un développeur. L’écart entre un benchmark choisi et une livraison fiable au quotidien restait important.
Le contrôle d’un ordinateur révélait cet écart encore plus clairement. Avec sa fonction de computer use d’octobre 2024, Anthropic permettait à Claude d’interagir avec un ordinateur à partir de captures d’écran et d’actions, tout en qualifiant la fonction d’expérimentale et sujette aux erreurs. Un clic déplacé ou un champ mal lu est anodin en démo, mais coûteux dans un vrai workflow.
Puis Anthropic a présenté le Model Context Protocol, ou MCP, en novembre 2024. Il proposait une façon commune de relier assistants, données et outils. L’interopérabilité n’est pas apparue comme par magie, mais chaque produit avait moins d’intégrations sur mesure à réinventer. À la fin de l’année, les composants étaient plus clairs : un modèle, une interface d’outils, un workflow persistant et des endroits où une personne pouvait intervenir.

2025 : les expériences deviennent des produits
OpenAI a lancé Operator en janvier 2025 comme aperçu de recherche d’un agent capable d’utiliser un navigateur. L’entreprise reconnaissait ses limites et la nécessité de remettre les étapes sensibles à un humain. En février, deep research a montré une forme d’agent plus utile : prendre le temps de trouver et de synthétiser l’information, puis fournir au lecteur des sources à vérifier. La recherche et les citations facilitent la vérification, comparativement à une longue série de clics dans des comptes actifs.
Le même mois, Anthropic a présenté Claude 3.7 Sonnet et Claude Code en aperçu de recherche. Le terminal était un environnement naturel pour un agent. Le code vit dans des fichiers. Les tests réussissent ou échouent. Un diff montre ce qui a changé. Si l’agent se trompe, le développeur peut refuser ou annuler le correctif.
En mai, OpenAI a présenté Codex comme agent de génie logiciel dans le cloud. Ses tâches tournaient dans des sandboxes et renvoyaient des changements à réviser. Codex CLI est l’interface locale distincte dans le terminal, une nuance importante pour comparer les produits. Anthropic a aussi rendu Claude Code largement disponible avec Claude 4. C’est le moment où « demander un changement à un agent, puis le réviser » a commencé à ressembler à un vrai workflow d’ingénierie.

Puis est arrivé un rappel important. Dans une étude randomisée de METR, 16 développeurs open source expérimentés ont travaillé sur 246 tâches dans des dépôts qu’ils connaissaient. Avec les outils du début de 2025 étudiés, l’accès à l’IA les a rendus 19 % plus lents. Avant l’étude, ils s’attendaient à être 24 % plus rapides; après, ils croyaient encore l’avoir été de 20 %. Ce résultat concerne ces développeurs, ces tâches et ces outils. Il ne prouve pas que tous les agents actuels ralentissent tout le monde. Il montre à quel point les démos, les benchmarks et même notre impression peuvent mal mesurer la productivité.

Pendant la deuxième moitié de 2025, ChatGPT agent, Claude pour Chrome, des outils de programmation améliorés, les skills et des systèmes plus mûrs ont élargi les possibilités. Les risques ont grandi aussi. Les navigateurs, boîtes courriel et documents externes donnent du contexte utile à l’agent, mais permettent également à du contenu non fiable d’influencer sa prochaine décision.
L’opinion publique changeait aussi. Dans une entrevue d’octobre 2025, Andrej Karpathy disait que les agents de programmation ne l’aidaient pas sur son propre projet et que le domaine aurait peut-être besoin d’une décennie. En février 2026, il décrivait un quotidien très différent : il confiait des tâches de programmation aux agents et révisait leurs résultats. Le revirement d’une seule personne n’est pas une étude contrôlée, mais il montre à quelle vitesse ces outils ont commencé à paraître différents aux utilisateurs expérimentés.
La fin de 2025 a ajouté une autre couche à l’architecture des agents. Anthropic a intégré des instructions réutilisables à son workflow agentique avec les skills, MCP est entré dans un cadre de gouvernance ouvert plus large, et OpenAI a lancé GPT-5.2-Codex pour les tâches de programmation plus longues. Je vois là des éléments du même virage : de meilleurs modèles dans des environnements plus mûrs, plutôt qu’une nouvelle boucle agentique.
2026 : la programmation et l’utilisation de l’ordinateur convergent
Le Cowork d’Anthropic a étendu le schéma agentique au travail général sur ordinateur. OpenClaw a montré la demande pour un agent local relié aux applications de messagerie. L’attrait est évident : un agent qui utilise votre ordinateur et vos services peut accomplir du vrai travail. La question de sécurité l’est autant. Chaque message, page Web et document lu par l’agent peut être une entrée non fiable, alors que les identifiants auxquels il a accès peuvent être puissants. La présentation du projet décrit son approche, mais sa popularité ne prouve ni sa sécurité ni son utilité.

En parallèle, les agents de programmation sont devenus plus capables et plus intégrés au contrôle de l’ordinateur. Cursor a décrit des agents cloud qui contrôlent leur ordinateur, tandis que l’expansion de Codex d’OpenAI reliait la programmation aux interactions de bureau et à davantage d’outils. Ces lancements ne signifient pas qu’on peut confier toutes les tâches à un agent sans surveillance. Ils montrent que la frontière entre code, navigateur, fichiers et bureau devient plus mince.
L’architecture d’un agent ne se résume pas à un modèle qui réfléchit plus longtemps. C’est un modèle placé dans un système qui peut agir, observer, récupérer et montrer son travail. De meilleurs modèles améliorent chaque étape; de bonnes limites empêchent une mauvaise étape de devenir coûteuse.
Où les agents fonctionnent le mieux aujourd’hui
Voici la règle que j’utiliserais vraiment : confiez aux agents du travail dont les échecs sont peu coûteux, visibles et réversibles. Un changement de code avec des tests et une pull request révisée correspond souvent à cette description. Une synthèse de recherche avec des sources à inspecter peut aussi convenir. Une instruction générale pour agir dans vos courriels, comptes financiers ou systèmes de production exige des contrôles beaucoup plus solides.
Voilà pourquoi je reviens si souvent aux agents de programmation dans cette histoire. Leur boucle de feedback est relativement bonne : les tests échouent, les diffs sont visibles et les branches peuvent être supprimées. Rien de tout cela ne rend la revue de code facultative. Cela rend l’autonomie utile plus facile à construire et à mesurer.
Le schéma ReAct d’origine est toujours là. Entre 2022 et 2026, ce sont la qualité du modèle, celle de ses outils et notre capacité à inspecter et contenir le résultat qui ont changé. La prochaine étape devrait se mesurer au vrai travail qui passe cette inspection, pas à l’impression qu’un agent travaille très fort.
Quel lancement ou quel échec d’agent a changé votre opinion ? J’aimerais savoir quelle étape de cette chronologie vous paraît la plus importante.
FAQ
Qu’est-ce qu’un agent IA ?
Ici, c’est un système qui utilise un modèle pour choisir des actions, interagir avec des outils ou un environnement, observer le résultat et recommencer pour atteindre un objectif. Un agent moderne a aussi besoin de limites, de vérifications et d’une révision humaine.
Pourquoi les premiers agents, comme AutoGPT, avaient-ils du mal ?
Les premiers agents disposaient de modèles moins puissants, de connexions fragiles aux outils, de peu d’isolation et de peu de moyens fiables pour vérifier leurs progrès. Ils pouvaient s’éloigner de l’objectif ou répéter des actions sans terminer la tâche.
Qu’est-ce qui a changé pour les agents de programmation en 2025 et 2026 ?
Des modèles plus puissants ont été intégrés à de meilleurs environnements, avec accès au dépôt, sandboxes, tests, diffs, points de contrôle et pull requests que les humains peuvent réviser.
MCP a-t-il rendu les agents fiables ?
MCP a donné une interface commune aux outils et aux sources de données, réduisant les intégrations sur mesure. Il ne vérifie pas les décisions de l’agent ; les permissions, les tests et la révision humaine restent nécessaires.
Les progrès sur les benchmarks prouvent-ils que les développeurs vont plus vite ?
Non. Les benchmarks mesurent des tâches définies dans des conditions précises. Dans une étude METR de 2025, 16 développeurs open source expérimentés ont été 19 % plus lents sur 246 tâches avec les outils IA du début de 2025, même s’ils s’attendaient à aller plus vite.
Où une équipe devrait-elle utiliser des agents en premier ?
Commencez par du travail limité dont les erreurs sont visibles, peu coûteuses à corriger et faciles à tester. Gardez une approbation humaine avant les actions coûteuses ou irréversibles.