La version courte
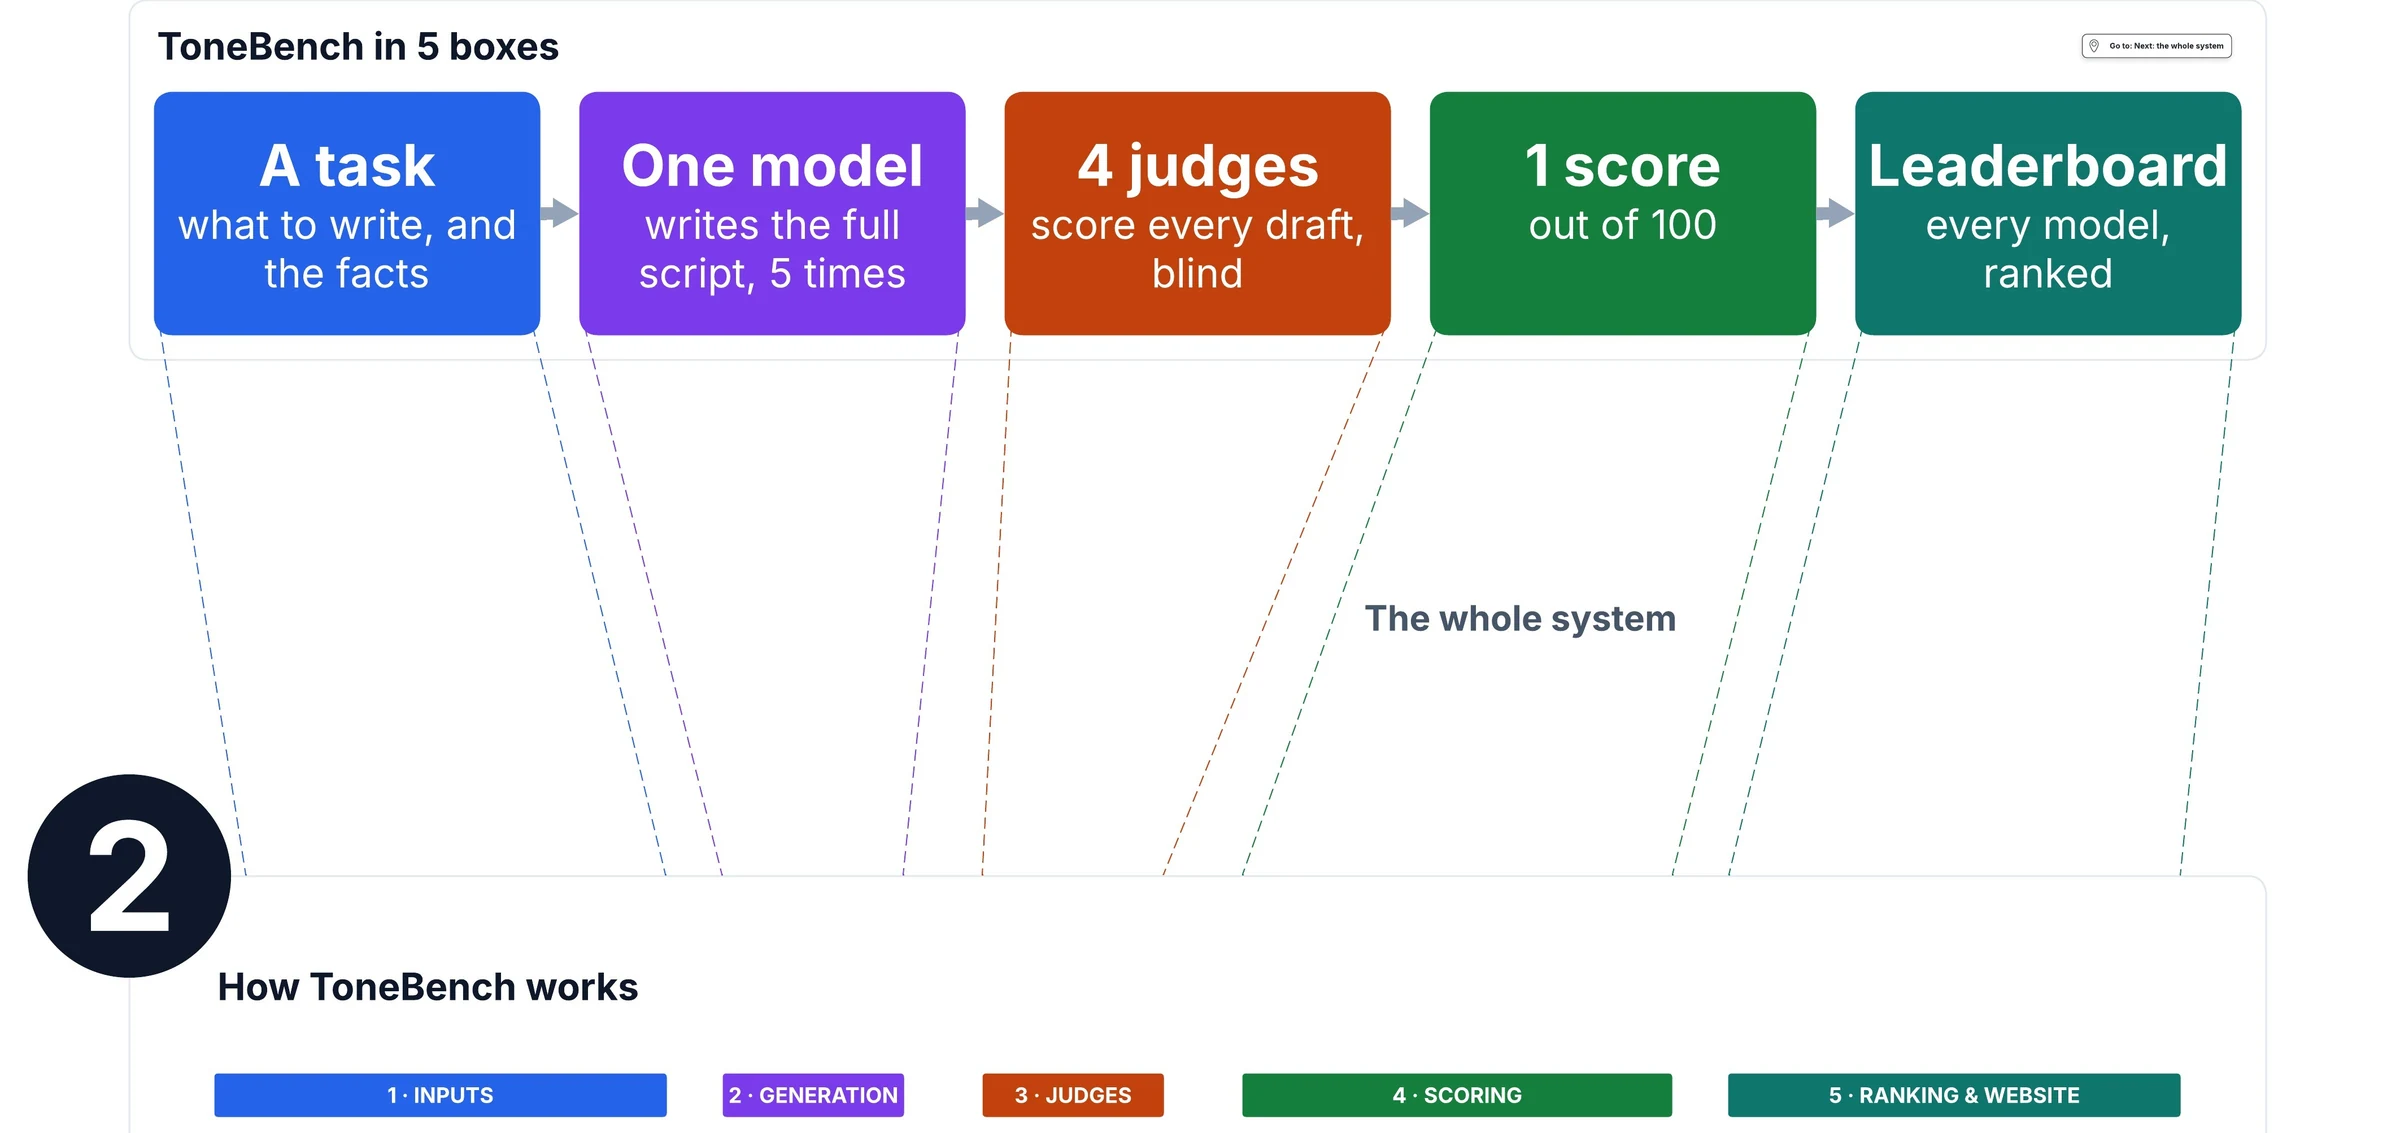
ToneBench donne à chaque modèle la même tâche, écrire un script complet avec ma voix, cinq fois pour chacune des 10 tâches. Quatre juges notent chaque brouillon à l’aveugle avec une grille détaillée, du code ajoute des vérifications de longueur et de slop, et le résultat pondéré donne un Writing Score sur 100. Les comparaisons deux à deux de ces scores donnent le Writing Elo qui établit le classement.
- Générez plusieurs brouillons par prompt : le même modèle peut écrire un excellent script et un script faible avec le même prompt, donc ToneBench en note cinq par tâche.
- Mesurez vos juges LLM avant de leur faire confiance. Dans le classement du 26 octobre 2026, GPT-6.1 Sol donnait aux brouillons d’OpenAI 4,1 points de plus que ce que prédisent les scores des autres juges LLM.
- Pour écrire à grande échelle, essayez une dizaine de brouillons bon marché fusionnés par un juge solide, une à trois rondes de révision par LLM, et toujours une révision humaine.
Pouvez-vous lire à voix haute un script généré par l’IA sans grincer des dents ? C’est la question à laquelle je voulais répondre avec ToneBench, le benchmark d’écriture que j’ai présenté à la conférence AI Engineer à New York en octobre 2026. Voici exactement comment il fonctionne, ce qu’il mesure, et le plus de détails possible sur la façon dont je l’ai construit, pour que vous puissiez, je l’espère, en tirer des leçons et améliorer vos prochaines évaluations. Je vais vous faire faire le tour complet du benchmark et vous donner mes meilleurs conseils pour travailler avec des juges LLM.
Pour être entièrement transparent, Lucid a commandité la vidéo d’où vient cet article, simplement pour montrer comment Lucid fonctionne. Mais l’article porte sur le benchmark : les meilleures leçons qu’on en a tirées pour construire des évaluations, et comment mieux écrire avec l’IA.
Si vous ne me connaissez pas, je suis Louis-François, CTO et cofondateur de Towards AI, où on construit des solutions d’IA et on forme des ingénieurs en IA.
Un tableau dessiné par Claude dans Lucid
Pour faire les visuels de cet article et de sa vidéo, j’ai utilisé un outil vraiment cool, Lucid. J’ai demandé à Claude d’analyser tout le dépôt du benchmark et de construire visuellement toute la présentation pour moi, pour que je n’aie rien à faire. Évidemment, je lui ai aussi donné plus de contexte et je lui ai déballé tout ce que je voulais couvrir.
Tout ça a été fait avec seulement quelques prompts, Claude Code et le serveur MCP de Lucid. Les visuels sont vraiment cool, et tout est personnalisable. Je peux zoomer, on peut commenter n’importe quelle partie pour demander des changements, et Claude peut répondre directement et les faire.
Fait cocasse, j’ai fait ce diagramme en 2016, quand j’étais à l’université. Il couvre quelques étapes de base d’un cours sur l’assemblage. Donc je trouve ça un peu fou que dix ans plus tard, Lucid m’ait contacté pour un partenariat sur une vidéo, pour que je montre leurs outils agentiques et comment Claude peut facilement construire avec Lucid pour visualiser des choses et communiquer avec votre équipe.

Mon plus vieux diagramme Lucid, créé le 23 octobre 2016. Visible à 1:03 dans la vidéo.
Et je me suis dit que c’était l’occasion parfaite de montrer comment j’ai construit le benchmark et toutes ses étapes. Il y a plein de fonctionnalités cool : vous pouvez zoomer sur chacune des sous-présentations, et Claude a créé de petits boutons pour passer à l’étape suivante, puis à la suivante, puis à la suivante. C’est vraiment pratique, et vous pouvez personnaliser chaque élément. Vous pouvez vraiment tout faire avec Lucid.
De quoi est fait le slop
Pire que les mots de slop, le texte de slop est généralement trop général. Il dit « la plupart des équipes », « la plupart des projets ». Malheureusement, je suis moi-même coupable de faire ça sur LinkedIn, mais pour être honnête, c’est la méta de LinkedIn. J’en ai tiré des leçons, et j’essaie vraiment d’être le plus précis possible maintenant.
Encore pire que les mots bâclés et le côté général, très souvent, le texte généré ne dit rien. C’est juste un tas de beaux mots avec du hype, enfilés les uns après les autres. C’est vraiment pénible à lire et à utiliser, surtout quand un collègue vous envoie un artefact bâclé qu’il n’a même pas relu.
Pire que de ne rien dire, il se répète beaucoup. Si vous travaillez beaucoup avec Claude, vous savez qu’il se répète. Vous voulez juste le résultat, savoir ce qu’il a fait, mais il répète la même chose plusieurs fois.
Encore pire, il hallucine, comme vous le savez, donc vous ne pouvez pas faire entièrement confiance à ce qu’il génère. Et finalement, le pire pour moi : il a le mauvais ton, ou pas de ton du tout. Il parle comme tout le monde, ou comme personne. Il ne parle certainement pas comme moi.
Donc le but de ToneBench, c’est d’essayer de mesurer cette écriture bâclée, cette écriture créative : mesurer si un système d’IA peut écrire comme moi, comme mes scripts vidéo, comme mon style d’écriture.

Partie 1 du tableau : les six ingrédients du slop, triés par Claude à partir de la transcription de ma présentation à AI Engineer. Visible à 2:18 dans la vidéo.
Tout sur ce tableau a été construit avec Claude Code, mais tout montre ce qui est réellement implémenté dans ToneBench.
Configurer Lucid dans Claude Code
Si vous voulez reproduire cette configuration, c’est vraiment facile à faire avec Claude Code, dans votre dépôt. J’ai simplement demandé à Claude de l’installer, mais vous avez seulement besoin de la commande claude mcp add pour ajouter Lucid :
claude mcp add --transport http lucid https://mcp.lucid.app/mcp
L’écran d’approbation qui s’ouvre après /mcp : autorisez une seule fois, et Claude peut lire, créer et modifier vos documents Lucid. Visible à 4:09 dans la vidéo.
À partir de là, Claude peut tout gérer dans Lucid pour vous et construire ces visuels facilement. Et bien sûr, vous pouvez l’utiliser dans ChatGPT, Cursor et plein d’autres outils, puisque c’est juste un serveur MCP auquel ils peuvent tous se connecter.
Juste pour le tester, je lui ai demandé de trouver mon plus vieux document sur Lucid, et c’était le diagramme de 2016 que vous avez vu plus haut.
Réviser le tableau avec des commentaires
Ensuite, j’ai demandé à Claude de tout construire. J’ai itéré sur un artefact, une page web que Claude construit et que je révise et commente, avec accès à Lucid et au script, pour obtenir toutes les différentes parties clairement conçues. Je l’ai commenté directement, comme vous pourriez le faire avec votre équipe dans Lucid, mais ici avec Claude.

La page de révision : garder, réviser ou retirer chaque graphique, avec des commentaires pour Claude. Ronde 5, 1er novembre 2026. Visible à 4:42 dans la vidéo.
Donc ce sont des itérations directes avec Lucid et les artefacts de Claude, où Claude lit mes commentaires et fait plusieurs rondes pour améliorer les visuels.

Mon commentaire sur le tableau, et la réponse de Claude dans le même fil après qu’il a ajouté la version en cinq boîtes. Visible à 4:52 dans la vidéo.
Comment fonctionne ToneBench
Retour au tableau : qu’est-ce que ToneBench fait et mesure, exactement ? C’est vraiment simple. On prend une tâche, qui consiste ici à écrire un script avec ma voix. On demande au modèle de la faire, puis on le juge, on lui donne un score, et on l’ajoute au classement.
On fait ça pour chaque modèle, et on n’a pas juste une tâche, mais dix tâches d’écriture différentes. Comme le montre le tableau, chaque modèle écrit cinq brouillons par tâche (j’y reviens très bientôt), notés par quatre juges : Claude Opus 5.5, GPT-6.1 Sol, GLM 5.3 Flash et Jev 1.13 (le jury en date du classement du 26 octobre 2026).
J’ai ajouté Jev récemment, et je pourrais faire une vidéo complète sur Jev. Si ça vous intéresse, dites-le-moi. Ensuite, on fait la moyenne des scores, on calcule un Writing Score, et on le publie sur le site. Je vais passer à travers tout ce processus de gauche à droite, étape par étape, et vous montrer exactement ce qu’on a implémenté et comment.

Partie 2 du tableau : le système complet. Une configuration, soit un modèle à un niveau d’effort, représente 50 brouillons et 200 jugements. Visible à 5:09 dans la vidéo.
Évidemment, je ne partagerai pas les prompts et les tâches exacts, parce que sinon le benchmark serait contaminé, et les modèles pourraient s’entraîner dessus. Je ne veux pas ça. Mais je vais en partager le plus possible pour que vous puissiez reproduire la même configuration.
Côté échelle : avec dix tâches et cinq brouillons chacune, chaque modèle a cinquante brouillons, ce qui donne deux cents jugements avec quatre juges. Ça fait beaucoup de tokens, puisque chaque tâche est un long script, certains d’environ vingt minutes de lecture. Pour les 141 configurations du classement du 26 octobre 2026, ça donne environ 1,6 milliard de tokens, en entrée et en sortie.
Comment un modèle écrit un script
Donc qu’est-ce que voit le modèle qui écrit le script ? Il reçoit mon guide de voix au complet : comment j’écris, comment je parle, des exemples de mes différents scripts, et plein de conseils sur ce que j’aime et ce que je n’aime pas. Même chose pour le guide de storytelling, qui est le plus détaillé possible sur la façon de bien écrire : des phrases actives, garder l’émotion tout au long du texte et la faire évoluer, avoir une histoire du début à la fin, tout ça.
Il reçoit aussi toutes les directives sur ce qu’il faut générer et comment : un brief complet, et un document de recherche complet avec des citations à utiliser, qu’on utilise aussi pour mesurer la partie hallucinations.
Ensuite, tout ça est donné au modèle, et cinq brouillons sont générés et notés.

Partie 3 du tableau : les mêmes intrants pour chaque modèle, chaque boîte dessinée selon son nombre de mots. Le modèle écrit sans accès externe : aucun outil, aucune recherche web, et il ne voit jamais mon script final. Visible à 6:30 dans la vidéo.
Pourquoi cinq brouillons
On génère cinq brouillons pour mesurer la variabilité intra-modèle. C’est une chose que Claude n’aurait pas suggérée. Avec mon expérience à faire des évaluations sur plein de systèmes d’IA avant ça, j’ai décidé de mesurer la variabilité entre les générations d’un même modèle avec le même prompt, juste pour voir s’ils génèrent la même chose.
Et comme vous pouvez le voir, pas du tout. Grok 4.7, par exemple, a une très grande variance d’une génération à l’autre, ce qui veut dire qu’il peut générer un très mauvais script et un très bon script complètement au hasard. Comparez ça à Claude Opus 5.5, qui est vraiment constant.
Et ce n’est pas à cause de la façon dont nos juges notent. C’est purement la qualité de la génération, parce que j’ai aussi optimisé nos quatre juges pour que ça n’arrive pas. Dans tous les cas, c’est vraiment bien de mesurer cette variabilité sur la même tâche répétée, juste pour voir si c’est constant, surtout quand vous choisissez un modèle final pour la production.

Même modèle, même prompt, même script, cinq fois. Dans le classement du 26 octobre 2026, Grok 4.7 (high) est 28e avec ses meilleurs brouillons et 62e avec ses pires, alors que Claude Opus 5.5 (xhigh) reste premier ou deuxième. Ces rangs classent les configurations selon le score moyen, pas selon le Writing Elo du classement. Visible à 7:11 dans la vidéo.
Comment un brouillon obtient son score
À partir de là, on génère les cinq brouillons. Voici comment on les note, et sur quoi les juges basent la note finale. Le prompt est assez gros : environ 20 000 mots.

Ce qu’un juge lit pour noter un brouillon, chaque partie dimensionnée selon son nombre de mots : 20 382 mots pour ce brouillon, et de 13 402 à 33 033 sur les 7 050 brouillons. Visible à 8:24 dans la vidéo.
En gros, on a huit métriques différentes avec des règles différentes, et chaque métrique a plein d’exemples de ce qu’on cherche : à quoi ressemble un bon résultat, à quoi ressemble un mauvais résultat. Le juge a aussi accès au brouillon qu’on vient de générer, pour pouvoir le juger, plus d’autres exemples pour qu’on puisse le guider et le calibrer le mieux possible sur de vrais scripts passés qu’on a.
Ensuite, nos juges choisissent un score pour chaque métrique. D’abord, les juges LLM repèrent les citations qui représentent le mieux le script. Ensuite, ils lui donnent un score et expliquent pourquoi ce score est le bon. On fait ça pour les huit métriques, plus deux scores calculés par du code : la longueur, où on compte les mots pour savoir si le brouillon respecte ce qu’on a demandé, et un score de slop qui utilise les listes de slop d’EQ-Bench et notre propre méthode de calcul du slop.
Finalement, on calcule une somme pondérée de toutes ces métriques selon leur importance. La note de slop des juges est intégrée à ce score de slop, donc le Writing Score pondère neuf métriques au final. Ça, c’est pour un juge. On fait ensuite la moyenne de tous nos juges, et on fait la même chose pour nos cinq brouillons.

Un vrai brouillon, étape par étape : Claude Opus 5.5 (xhigh), brouillon 4 sur 5 pour une des dix tâches. 88,18 pour un juge, 88,86 pour quatre juges, 87,91 sur cinq brouillons, et un Writing Score de 85,83 sur les dix scripts, deuxième sur 141 configurations dans le classement du 26 octobre 2026. Visible à 8:53 dans la vidéo.
L’échelle Tone & Voice
Pour arriver au score, on a en fait six grandes catégories, et à l’intérieur de chacune, une note. On a vu que ça fonctionnait mieux qu’une notation binaire, probablement à cause de la subjectivité de la tâche, et mieux que d’utiliser seulement des catégories ou seulement des pourcentages.
Je ne sais pas trop pourquoi, mais on a tout mesuré, et c’est le meilleur compromis qu’on a trouvé pour la constance et la fiabilité, entre nos juges et sur plusieurs générations notées. Le juge choisit d’abord une grande catégorie, avec plein de détails sur ce qu’est chaque catégorie et des exemples, et ensuite il choisit une note, encore une fois à partir d’exemples de ce qu’est un 85 pour cette tâche.
Honnêtement, je vais continuer de l’enrichir avec plus d’exemples pour qu’elle soit encore plus fiable.

Comment un juge LLM note Tone & Voice : citer des preuves, choisir un des six niveaux, puis un score à l’intérieur. Jev, le quatrième juge, choisit plutôt parmi cinq niveaux décrits. Visible à 9:34 dans la vidéo.
Vous voulez vraiment travailler fort sur cette partie, qu’on appelle la grille d’évaluation, parce que si vos juges LLM sont biaisés, tout le benchmark est biaisé, et donc inutile.
Peut-on faire confiance aux juges ?
J’ai aussi mesuré si on peut faire confiance à nos juges, et voici ce qu’on a trouvé. Plus un point est loin vers l’extérieur, plus ce juge favorise les brouillons de ce labo. Prenez GPT-6.1 Sol, la ligne verte : quand il note des modèles d’OpenAI, il les favorise vraiment, de loin. Même chose pour le juge d’Anthropic. Et comme vous pouvez le voir, ce qui est logique, le juge d’Anthropic semble sévère envers les brouillons d’OpenAI, et le juge d’OpenAI semble sévère envers ceux d’Anthropic. C’est en partie parce que le graphique compare chaque juge aux autres juges LLM : quand un juge est généreux avec son propre labo, les autres semblent sévères envers ce labo. Et certains modèles sont plus biaisés que d’autres comme juges.
GLM est assez bon, et vous voulez vraiment être près de cette ligne noire, qui veut dire que vous ne seriez pas biaisé du tout. Même chose pour Claude, qui est en fait plutôt bon. Il préfère évidemment son propre labo, mais pas tant que ça comparé aux autres.
Jev est assez bizarre aussi : il préfère les brouillons d’Alibaba aux autres, et il ne semble pas aimer ceux d’OpenAI non plus. J’ai aussi testé récemment l’ajout de Gemini comme juge, mais il préférait clairement les modèles de Google, à peu près autant que GPT-6.1 Sol préfère ceux d’OpenAI, donc je ne l’ai finalement pas ajouté.

Partie 6 du tableau : les points que chaque juge ajoute ou retire aux brouillons d’un labo, comparativement à ce que prédisent les scores des autres juges LLM. L’anneau en gras correspond à zéro. Dans le classement du 26 octobre 2026, GPT-6.1 Sol donne +4,1 à OpenAI, Claude Opus 5.5 donne +2,2 à Anthropic et GLM 5.3 Flash donne +0,6 à Z.ai, un écart que le classement ne peut pas distinguer de zéro. Visible à 10:33 dans la vidéo.
Je cherche toujours à améliorer tout ce système. En ce moment, je mesure aussi constamment si ajouter plus de juges a du sens et aide les résultats ou non.
Garder les juges honnêtes
Pour que ce soit encore plus fiable, on y met du temps humain. On a d’abord fait environ un millier de comparaisons entre deux petits extraits, en disant lequel on préfère, pour que nos juges aient une idée de nos préférences.
Mais je pense que ce n’était pas assez. Donc à la place, on a fait 240 notations humaines détaillées, métrique par métrique, avec tous les détails de ce qu’on pense, et on a utilisé ces 240 notations humaines pour calibrer les juges. Donc on mesure si les juges LLM notent comme nous.
Et à partir de là, j’essaie d’utiliser cette calibration pour continuer à mettre à jour le benchmark.

La boucle qui garde les juges honnêtes : les évaluations humaines affinent la grille, les juges renotent chaque brouillon, et on les compare à des humains. Visible à 11:47 dans la vidéo.
Comment j’écrirais avec l’IA aujourd’hui
Maintenant, la partie peut-être la plus intéressante pour beaucoup d’entre vous : comment utiliser ce benchmark pour mieux écrire ? C’est quelque chose que j’expérimente en ce moment. Mais d’après ce que j’ai vu, et selon ce qu’on a dit sur la variabilité intra-modèle, les modèles « moins bons » génèrent des scripts très différents d’une génération à l’autre, même avec le même prompt.
Donc au lieu d’utiliser le meilleur modèle du benchmark, en ce moment Claude Opus 5.5, pour générer un brouillon au niveau d’effort extra high, j’utiliserais un modèle moins bon et plus petit comme GLM-5.3 Flash, je générerais dix brouillons différents, et ensuite je choisirais et fusionnerais le meilleur de chaque brouillon avec un juge très puissant pour créer le résultat final.
Ça semble bien meilleur, parce que GLM-5.3 Flash est assez proche d’Opus 5.5, mais il coûte beaucoup moins cher à exécuter. Donc même si vous générez dix brouillons et utilisez un juge pour les fusionner, c’est beaucoup moins cher que de générer un brouillon d’un coup avec Opus. Dans le classement du 26 octobre 2026, GLM-5.3 Flash obtient 81,8 pour environ 0,02 $ par brouillon, contre 85,8 pour environ 1,00 $ par brouillon pour Opus 5.5 au niveau d’effort extra high.

Partie 7 du tableau : le chemin de la meilleure qualité et le chemin le moins cher à grande échelle, qui se rejoignent aux mêmes révisions. Visible à 12:54 dans la vidéo.
Et pour lui donner le meilleur intrant possible : le plus de détails possible, plein d’exemples, des exemples exacts de votre voix et de ce à quoi vous voulez que les générations ressemblent et ne ressemblent pas. Si vous le pouvez, même des textes passés complets, comme d’anciennes infolettres ou d’anciennes publications LinkedIn, peu importe ce que vous voulez générer.
Finalement, on recommande aussi une à trois rondes de révision par un juge LLM, pas plus. Dans mon cas, quand je produis un brouillon, j’utilise le juge LLM qu’on a dans le benchmark, je le lance une fois pour donner du feedback au rédacteur, le rédacteur améliore le brouillon, et c’est tout.
Je fais juste une ronde, sinon ça tourne au bâclé. Et j’ai vu que ça aide énormément la génération. Tout ça peut tenir dans un seul prompt : vous demandez au LLM que vous utilisez de lancer un sous-agent qui juge et révise le brouillon selon un prompt de révision que vous lui donnez. Ça pourrait être exactement le même prompt d’entrée, et vous demandez juste une vraie révision avec du feedback, puis il réécrit une fois.
Et idéalement, vous voulez évidemment une révision humaine, parce que c’est là que vous ajoutez vos propres idées personnelles. Vous voulez qu’on puisse s’y reconnaître, d’humain à humain. Les gens aiment créer un lien avec une personne précise, donc ça doit être constant dans vos publications, vos vidéos, votre contenu. Et heureusement ou malheureusement, Claude ne peut pas faire cette partie à votre place.
Mes notes et mon backlog, sur le même tableau
Donc c’est tout le benchmark. C’est aussi comme ça que j’ai utilisé Lucid pour expliquer le fonctionnement du benchmark à mon équipe, et ici dans cet article. Je l’utilise aussi pour tout noter, et évidemment, ce n’est pas moi qui l’ai conçu. Je n’aurais pas la patience d’ajouter des Post-it et des trucs jolis comme ça, mais Claude l’a fait pour moi. J’aime vraiment qu’un outil que j’utilise depuis dix ans puisse maintenant m’aider automatiquement, juste avec Claude, intégré à ma configuration actuelle. C’est génial.

Partie 8 du tableau : mes notes de présentation, notre backlog et ce que les gens ont demandé sur X après le lancement, groupés par thème avec les prochaines actions. Visible à 14:53 dans la vidéo.
Si vous voulez essayer Lucid, ses outils agentiques et son serveur MCP, commencez sur lucid.co. Et si vous voulez plus d’idées pour améliorer votre écriture avec l’IA, ou plus de détails sur la méthodologie derrière le benchmark, tout est sur le site de ToneBench et sa page de méthodologie.
Un petit avertissement avant de choisir un modèle
Ce benchmark mesure vraiment ma propre voix. Si un modèle s’en tire bien, il peut probablement s’adapter à votre ton aussi, si vous lui donnez un prompt aussi bon que le mien. Donc c’est vraiment important d’écrire un très bon prompt détaillé. C’est la partie la plus importante. Le benchmark est juste un signal pour :
- utiliser les trois meilleurs modèles du benchmark,
- les essayer sur votre tâche,
- et faire vos propres évaluations avec des juges LLM, en utilisant les leçons qu’on vient de voir, pour les mesurer sur votre tâche.
J’espère que c’était utile. Si vous voulez plus de détails sur une partie, dites-le-moi. Je serais content de faire une vidéo de suivi avec encore plus de détails sur les juges LLM et comment je les ai rendus plus fiables, ou sur tout ce que vous voulez savoir sur les évaluations, ce benchmark ou l’ingénierie IA en général.
FAQ
Qu’est-ce que ToneBench ?
ToneBench est mon benchmark d’écriture, sur benchmark.towardsai.com. Il mesure si un modèle peut écrire un script YouTube complet avec ma voix. Dans le classement du 26 octobre 2026, il classe 141 configurations sur 10 tâches, avec cinq brouillons chacune.
Comment les juges LLM notent-ils un brouillon dans ToneBench ?
Chaque juge LLM cite d’abord le brouillon, choisit un des six niveaux, puis un score à l’intérieur de ce niveau, et explique le score en une phrase, pour huit métriques. Le code ajoute la longueur et une partie du score de slop, et une somme pondérée donne le Writing Score.
Pourquoi ToneBench génère-t-il cinq brouillons par tâche ?
Pour mesurer la variabilité intra-modèle. Dans le classement du 26 octobre 2026, Grok 4.7 (high) était 28e avec ses meilleurs brouillons et 62e avec ses pires, alors que Claude Opus 5.5 (xhigh) restait premier ou deuxième, peu importe les brouillons retenus.
Les juges LLM favorisent-ils les modèles de leur propre labo ?
Oui, de façon mesurable. Dans le classement du 26 octobre 2026, GPT-6.1 Sol donnait 4,1 points de plus aux brouillons d’OpenAI et Claude Opus 5.5, 2,2 points de plus à ceux d’Anthropic, comparativement à ce que prédisent les scores des autres juges LLM. Comme on fait la moyenne de quatre juges de quatre entreprises, chaque préférence n’entre dans le Writing Score qu’au quart de sa taille.
Qu’est-ce que Jev, le quatrième juge de ToneBench ?
Jev 1.13, de TypeSafe, est un juge typé : il n’écrit aucun texte et répond à chaque métrique en choisissant parmi cinq niveaux de qualité décrits, avec une probabilité pour chacun. Son concepteur n’a aucun modèle dans le classement.
Quel modèle devrais-je utiliser pour écrire avec l’IA ?
Testez les trois meilleurs modèles du benchmark sur votre propre tâche. Dans le classement du 26 octobre 2026, Claude Opus 5.5 au niveau d’effort extra high obtenait 85,8 pour environ 1,00 $ par brouillon, et GLM-5.3 Flash, 81,8 pour environ 0,02 $. C’est pourquoi je fusionnerais une dizaine de brouillons bon marché avec un juge solide.
Comment connecter Lucid à Claude Code ?
Lancez claude mcp add avec le transport http et l’URL du serveur de Lucid, https://mcp.lucid.app/mcp, puis tapez /mcp dans Claude Code, choisissez Lucid et connectez-vous dans votre navigateur. Le même serveur MCP fonctionne aussi dans ChatGPT, Cursor et d’autres clients MCP.