La version courte
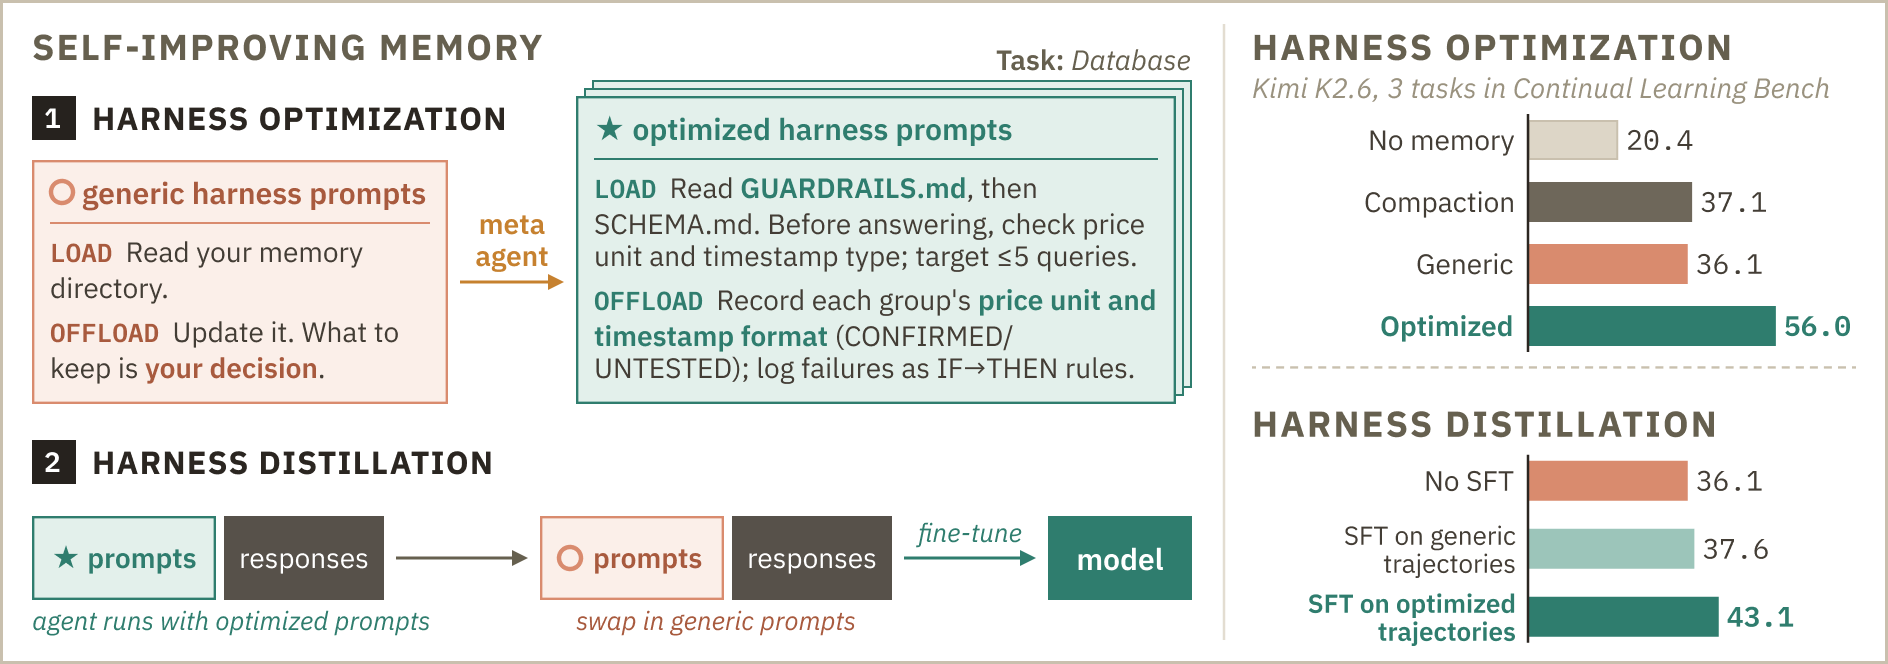
Self-Improving Memory est une recherche de l’équipe RAM de Meta où un seul modèle, Kimi K2.6, améliore la façon dont il gère sa propre mémoire en deux étapes. D’abord, un méta-agent du même modèle lit les exécutions passées de l’agent et réécrit les deux prompts qui disent quoi lire dans la mémoire et quoi sauvegarder (l’optimisation du harness, harness optimization). Ensuite, le modèle est fine-tuné avec LoRA sur ses meilleures exécutions, avec les prompts optimisés remplacés par les génériques, de sorte qu’une partie du gain passe dans ses poids (la distillation du harness, harness distillation). La méthode a été testée sur trois tâches de Continual Learning Bench, et c’est un article de blogue sans article scientifique pour l’instant, en date du 21 novembre 2026.
- La mémoire dépend de la tâche. Entre des questions SQL, des correctifs dans un dépôt et des balayages radio, aucun design de mémoire (résumé, recherche d’information, skills ou hypothèses) n’a gagné sur les trois tâches.
- Les prompts que le modèle s’est écrits lui-même ont obtenu 56 en moyenne sur les trois tâches, contre environ 45 pour les meilleurs prompts écrits à la main et le milieu de la trentaine pour un prompt générique. Ce sont les meilleurs scores observés, sur trois tâches et avec un seul modèle.
- Fine-tuné sur ses propres meilleures exécutions, avec seulement le prompt générique, le modèle a obtenu 43,1 en moyenne, contre 37,6 lorsqu’il est fine-tuné sur ses exécutions ordinaires. L’entraînement a conservé une partie du gain.
Ça y est enfin ! Les agents commencent à s’optimiser et à se réentraîner eux-mêmes !
Bon, je sais ; j’ai même partagé mon setup récemment, où on pouvait déjà faire en sorte que les agents s’optimisent eux-mêmes avec le temps. C’est vraiment facile à faire avec un prompt qui lui dit de revoir votre interaction et d’améliorer le skill que vous utilisez, et vous faites ça à chaque exécution.
Vous pouvez pousser ça plus loin avec des données d’analytique, identifier des fonctionnalités à tester en A/B et lancer tout ça automatiquement chaque jour, pour améliorer le SEO de votre site web ou de votre application.
Mais j’ai quelque chose de nouveau aujourd’hui, où des modèles de langage se réentraînent littéralement eux-mêmes. Ça vient d’une nouvelle recherche vraiment cool sur laquelle je suis tombé sur le blogue de Meta.
Le TL;DR très simple, c’est qu’ils ont demandé à un modèle de résoudre une tâche en plusieurs étapes, quelque chose qui demande plusieurs allers-retours, et de le faire en s’appuyant sur différents types de mémoire, comme la résoudre en gardant tout dans le prompt, ou en maintenant un résumé des prompts et des outputs passés, ou en utilisant des skills ou même notre bon vieux RAG.
Mais ensuite, ils ont demandé au même modèle de digérer tous ces essais sur la tâche, de choisir les prompts qui ont mené aux meilleurs résultats et, au bout du compte, d’en faire un dataset et de réentraîner ce même modèle.
Si c’était trop rapide, ne vous en faites pas, on va passer à travers tout ce qu’ils ont fait et pourquoi c’est si cool, parce qu’il y a encore plus que ça !
Si vous ne me connaissez pas encore, je suis Louis-François, CTO et cofondateur de Towards AI, où on transforme des ingénieurs en ingénieurs IA qui bâtissent et livrent des produits d’IA.
L’expérience : un agent, un dossier de mémoire et deux prompts
Bon, alors détaillons un peu plus l’expérience elle-même. L’agent de Meta, basé sur le modèle Kimi K2.6, traverse une série de tâches reliées. Donc pas juste une, mais plusieurs tâches. Chacune commence avec un contexte vide, et la seule chose qui se transmet de l’une à l’autre, c’est un dossier de fichiers dans lequel l’agent lit et écrit.
À ce point de départ, il y a seulement deux prompts dans le harness de l’agent. On a un prompt appelé LOAD avant chaque sous-tâche, qui dit quoi lire. Le deuxième prompt, OFFLOAD, est envoyé seulement une fois la sous-tâche terminée et dit quoi sauvegarder. Dans leur version générique, ce sont des prompts super simples, du genre : lis ta mémoire, mets-la à jour, c’est toi qui décides quoi garder.

Le harness générique : chaque sous-tâche se termine par OFFLOAD, les suivantes commencent par LOAD, et seul le dossier de mémoire se transmet. Figure tirée de l’article de blogue Self-Improving Memory de Meta.
Donc, le but principal est que le modèle décide quoi sauvegarder quand il termine une tâche pour mieux réussir la suivante.
Quatre designs de mémoire, et le meilleur change selon la tâche
Mais il ne s’agit pas seulement de sauvegarder les prompts et les résultats traités dans la tâche en cours. Les chercheurs ont en fait donné quatre façons de sauvegarder des données dans la mémoire du harness, qui sont toutes des designs de mémoire classiques : un résumé continu, la recherche d’information (RAG), une bibliothèque de skills et le suivi d’hypothèses, où le modèle sauvegarde simplement des suppositions supplémentaires pour les confirmer plus tard. Ils les ont testés sur trois tâches de Continual Learning Bench : des questions SQL, la correction de problèmes dans un dépôt et le repérage de canaux occupés dans des balayages radio.
Donc, un premier but de l’expérience ici était de comparer ces quatre façons de mettre à jour la mémoire d’un harness. Et, comme prévu, le meilleur design changeait selon la tâche.

Les trois tâches, avec un exemple chacune, et le score de chaque design de mémoire par tâche. Le marqueur indique le meilleur design, et il est différent pour chaque tâche. Figure tirée de l’article de blogue Self-Improving Memory de Meta.
Et c’est une chose qu’on peut déjà retenir de cette recherche, même si on ne réentraîne pas de modèles nous-mêmes. La mémoire dépend de la tâche. Parfois le RAG est idéal, d’autres fois il faut juste tout mettre dans le prompt, et dans les situations où vous pouvez tester et comparer, comme en code, simplement garder des suppositions et les exécuter pour vrai chaque fois que c’est possible bat tout le reste. Et si vous voulez bâtir une mémoire basée sur des fichiers comme celle-ci pour vos propres agents, j’ai écrit sur une mémoire que vos agents IA peuvent réutiliser.
Laisser le modèle apprendre son propre design de mémoire
Bon, alors ils ont laissé le modèle apprendre son propre design de mémoire à partir des quatre options : Summary, Retrieval, Skill et Hypothesis. Ce qui veut dire qu’ils partent non pas d’une, mais de quatre courtes paires LOAD et OFFLOAD écrites à la main.
Ensuite, ils font passer l’agent à travers toute la série de tâches avec chaque combinaison de système de mémoire et de prompt, et ils le font cinq fois. Ça fait beaucoup d’exécutions. On a 3 tâches, 4 systèmes de mémoire à comparer, donc ça fait 60 exécutions dans cette première ronde. À chaque ronde, les quatre meilleures deviennent des « parents ». Un peu comme un algorithme évolutionnaire. En fait, exactement un algorithme évolutionnaire.
Après cette première ronde, un méta-agent du même modèle, encore Kimi, lit ce qui s’est passé : les historiques de messages, les scores et le dossier de mémoire qu’il a produit. Il résume chaque sous-tâche, analyse chaque exécution, trouve les échecs récurrents et réécrit les prompts LOAD et OFFLOAD. Chaque réécriture retourne dans le bassin pour être notée, et le cycle recommence. Ça veut dire que Kimi réécrit ses propres instructions après avoir lu ses propres erreurs.

L’étape Discover : le bassin de paires LOAD et OFFLOAD va au méta-agent, qui propose une nouvelle paire qui retourne dans le bassin pour être notée. Figure tirée de l’article de blogue Self-Improving Memory de Meta.
Tout comme chacun de mes skills se termine par un prompt pour digérer l’interaction en cours et l’améliorer, je vous recommande fortement d’implémenter cette boucle de feedback dans tous vos skills si vous ne l’avez pas déjà !
À quoi ressemble la boucle sur la tâche de correction de dépôt
Laissez-moi vous montrer à quoi ressemble cette boucle ici, avec Kimi sur la tâche de correction de dépôt. Le design à résumé continu battait à peine le prompt générique. Le méta-agent a remarqué que sa mémoire était un seul fichier qui n’arrêtait pas de grossir, donc l’agent redécouvrait sans cesse le dépôt, et il a réécrit les prompts pour réutiliser le chemin du dépôt enregistré et écrire une règle après chaque échec. Le score est passé du milieu de la trentaine au début de la cinquantaine.
Ensuite, on revient à quatre candidats, maintenant les quatre meilleurs jusqu’ici, les nouveaux parents. Leur rapport suivant a trouvé un seul fichier en ajout seulement, sans index des symptômes vers les correctifs, donc la réécriture suivante a ajouté un guide de démarrage rapide, un tableau des symptômes vers les correctifs et un fichier par correctif, et le score a encore monté.

Les prompts LOAD et OFFLOAD sur la tâche Codebase, de la version générique à la meilleure révision, avec leurs scores et le rapport du méta-agent entre chaque réécriture. Figure tirée de l’article de blogue Self-Improving Memory de Meta.
Ce que donnent les prompts écrits par le modèle
Voici donc ce que donnent les prompts écrits par le modèle, en moyenne sur les trois tâches. L’option sans mémoire obtient environ 20, un prompt générique se situe au milieu de la trentaine, le meilleur prompt écrit à la main qu’ils ont trouvé a obtenu environ 45, et les prompts que le modèle a écrits lui-même ont atteint 56 !

Scores de test par tâche et en moyenne pour l’absence de mémoire, la compaction, le prompt générique, les meilleurs prompts écrits à la main et les prompts que le modèle a optimisés lui-même. Figure tirée de l’article de blogue Self-Improving Memory de Meta.
Et c’est aussi pourquoi je n’ajuste plus vraiment mes skills à la main. Les modèles sont assez bons pour les gérer eux-mêmes. Ici, ça bat même un prompt écrit à la main et soigneusement optimisé, juste par le volume et les itérations automatisées.
Notez simplement que ça n’arrive pas à tout coup, évidemment. Parfois, le modèle part en boucle, devient brouillon, et les résultats ne font qu’empirer. Ça arrive souvent quand on écrit avec des LLMs, par exemple. C’est pourquoi je lui dis toujours de faire une seule ronde de révision du feedback. Mais pour d’autres tâches, comme le code ici, c’est super utile.
Entraîner le modèle sur ses propres meilleures exécutions
Et ils ne s’arrêtent pas là. On n’a pas encore parlé de réentraîner un modèle. Jusqu’ici, c’était juste de l’optimisation de prompts et d’instructions, avec des tonnes d’itérations et d’ajustements.
Une fois qu’ils ont les résultats après ces multiples rondes, ils exécutent le modèle avec ses meilleurs prompts une fois au complet sur les mêmes tâches et enregistrent chaque appel : réponses, raisonnement, appels d’outils. Ça devient un tout nouveau dataset.
Le seul changement qu’ils ont à faire pour que le modèle s’améliore lui-même à partir de ces données, c’est de remplacer les prompts optimisés par les génériques et de garder les réponses exactement telles quelles. Ensuite, un fine-tuning LoRA, un petit ensemble de poids ajouté au modèle, lui apprend à agir comme s’il avait le bon prompt alors qu’il ne voit que le court. De cette façon, il apprend à mieux se comporter même à partir de directives courtes et floues. Ça rendrait les modèles pas mal meilleurs pour la plupart des gens, je pense !

Demonstrate et Distill : les prompts LOAD et OFFLOAD optimisés sont remplacés par les génériques, les réponses restent les mêmes, et le modèle est entraîné sur ses propres réponses. Figure tirée de l’article de blogue Self-Improving Memory de Meta.
Et le plus cool, c’est qu’avec seulement le prompt générique, le modèle réentraîné est maintenant clairement meilleur que le modèle de base, et meilleur que le modèle fine-tuné sur ses propres exécutions ordinaires, sans l’optimisation.

Scores de test avec le prompt générique seulement : le modèle de base, le modèle fine-tuné sur ses exécutions génériques et le modèle fine-tuné sur ses exécutions avec les prompts optimisés. Figure tirée de l’article de blogue Self-Improving Memory de Meta.
Ça veut dire que le modèle peut optimiser son propre harness, puis s’entraîner dessus pour conserver une partie de cette optimisation. Maintenant, on peut continuer à répéter ce processus et voir où ça mène ! Ils ne l’ont pas testé dans la recherche, mais ce serait pas mal cool à voir dans de futures itérations !
Ce qui est nouveau ici, et ce qui ne l’est pas
Et, en passant, rien de tout ça n’est nouveau pris séparément : l’optimisation de prompts, la distillation de contexte et le fait de lier l’ajustement du harness au fine-tuning, comme WHALE, Co-Harness et Harness-Zero, tout ça existe déjà. Ce qui est nouveau ici, c’est de le faire uniquement sur les instructions de mémoire, avec un seul modèle dans les deux rôles et un simple remplacement de prompt. L’optimisation de la mémoire, et le fait de la mettre dans les poids mêmes du modèle en le réentraînant. Si le mot harness est nouveau pour vous, je l’ai expliqué dans mon article sur le harness engineering.
Ça reste un article de blogue, sans article scientifique associé au moment où j’écris ces lignes, sur trois tâches, un seul modèle et les meilleurs scores observés. Donc ce n’est pas une vérité établie que les modèles évoluent maintenant par eux-mêmes et vont dominer le monde demain. Mais c’est un signal très intéressant du côté de la gestion de la mémoire.
Ce qu’il faut en retenir
Alors, qu’est-ce que vous en retenez ?
Premièrement, enregistrez les exécutions complètes de votre agent et son dossier de mémoire après chaque tâche, puisque c’est ce que le méta-agent lit.
Deuxièmement, transformez les échecs en règles : le prompt gagnant pour la base de données disait d’enregistrer chaque échec sous forme de règle si-alors, et les prompts du dépôt faisaient la même chose.
Troisièmement, et seulement avec une évaluation en laquelle vous avez confiance, laissez un modèle proposer des réécritures, notez-les sur des tâches qu’il n’a jamais vues et ne gardez que les gagnantes.
Et c’est ça que je trouve si cool : on est passé d’un prompt à la fin d’un skill qui l’améliore, à un méta-agent qui réécrit les instructions, à un modèle qui s’entraîne sur ses propres meilleures exécutions.
En passant, si ça vous a intéressé, je parle de gestion de la mémoire et de bien plus dans mon prochain livre, AI Engineering for Production. C’est notre deuxième livre après Building LLMs for Production. Ce sera une incroyable bible d’environ 600 pages sur l’ingénierie IA, et si cet article vous a intéressé, c’est le livre parfait pour vous ! Vous pouvez vous inscrire à la liste d’attente pour savoir quand il sortira.
C’est la première analyse de recherche comme celle-ci que je fais depuis longtemps. Dites-moi si vous avez aimé et si vous aimeriez en voir plus ! J’espère que vous l’avez appréciée autant que j’ai aimé la faire !
FAQ
Qu’est-ce que Self-Improving Memory ?
C’est une recherche de l’équipe RAM de Meta, publiée sous forme d’article de blogue en novembre 2026. Un modèle réécrit d’abord les prompts qui gèrent sa propre mémoire et garde les versions qui obtiennent les meilleurs scores, puis il est fine-tuné sur les exécutions qu’il a produites avec ces prompts. Le même modèle, Kimi K2.6, joue à la fois l’agent et le méta-agent qui réécrit les prompts.
Qu’est-ce que l’optimisation du harness (harness optimization) ?
C’est la première étape. Le harness de l’agent a deux prompts de mémoire : LOAD, envoyé avant chaque sous-tâche, dit quoi lire, et OFFLOAD, envoyé après, dit quoi sauvegarder. Un méta-agent lit les historiques de messages, les scores et le dossier de mémoire des exécutions passées, trouve les échecs récurrents et réécrit les deux prompts. Chaque réécriture est notée, et les quatre meilleures deviennent les parents de la ronde suivante.
Qu’est-ce que la distillation du harness (harness distillation) ?
C’est la deuxième étape. Le modèle exécute les tâches une fois avec ses meilleurs prompts et chaque appel est enregistré. Les prompts optimisés sont ensuite remplacés par les génériques pendant que les réponses restent exactement telles quelles, et un fine-tuning LoRA apprend au modèle à agir comme s’il avait le bon prompt alors qu’il ne voit que le court.
Quel design de mémoire fonctionne le mieux pour les agents IA ?
Ça dépend de la tâche. Meta a comparé un résumé continu, la recherche d’information (RAG), une bibliothèque de skills et le suivi d’hypothèses sur trois tâches, et aucun design n’a gagné sur les trois. Testez-les sur votre propre tâche au lieu d’en choisir un par défaut.
Les prompts du modèle ont-ils battu ceux écrits à la main ?
Sur ces trois tâches, oui. En moyenne sur les tâches, l’absence de mémoire obtenait environ 20, un prompt générique 36,1, les meilleurs prompts écrits à la main 44,6 et les prompts du modèle 56,0. Ce sont les meilleurs scores observés, sur trois tâches et avec un seul modèle.
Est-ce que ça veut dire que l’IA s’améliore maintenant toute seule ?
Non. C’est un article de blogue sans article scientifique associé pour l’instant, sur trois tâches et un seul modèle, et le modèle fine-tuné ne garde qu’une partie du gain. Il faut aussi une évaluation en laquelle vous avez confiance pour noter chaque réécriture. Donc ce n’est pas la preuve que les modèles évoluent maintenant par eux-mêmes, mais c’est un signal très intéressant pour la gestion de la mémoire.
Que puis-je réutiliser de tout ça dans mes propres agents ?
Enregistrez les exécutions complètes de votre agent et son dossier de mémoire après chaque tâche. Transformez les échecs en règles, écrites sous forme d’énoncés si-alors. Et seulement avec une évaluation en laquelle vous avez confiance, laissez un modèle proposer des réécritures de ses instructions, notez-les sur des tâches qu’il n’a jamais vues et ne gardez que les gagnantes.